MySQL
DQL 单表数据查询
SELECT 语法、条件过滤、分组、排序与分页
增删改
-- 插入数据
insert into <表名> values (<值1>, <值2>, ...);
-- 插入指定数据
insert into <表名> (<字段名1>, <字段名2>, ...) values (<值1>, <值2>, ...);
-- 插入多行数据
insert into <表名> values
  (<行1值1>, <行1值2>, ...),
  (<行1值1>, <行1值2>, ...);

-- 更新数据,没有 where 会统一修改表中的所有数据
update <表名> set <字段名1> = <新值1> [, <字段名2> = <新值2> ...] [where <条件>];

-- 删除数据,没有 where 表中数据会被清空
delete from <表名> [where <条件>];
单表查询
-- distinct 去重,去除的是查出来的数据重复
select distinct <字段...> from <库名>.<表名>
  where <条件>
  group by <分组条件>
  having <过滤条件>
  order by <排序字段> {ASC 升序 | DESC 降序} -- 默认升序
  limit n;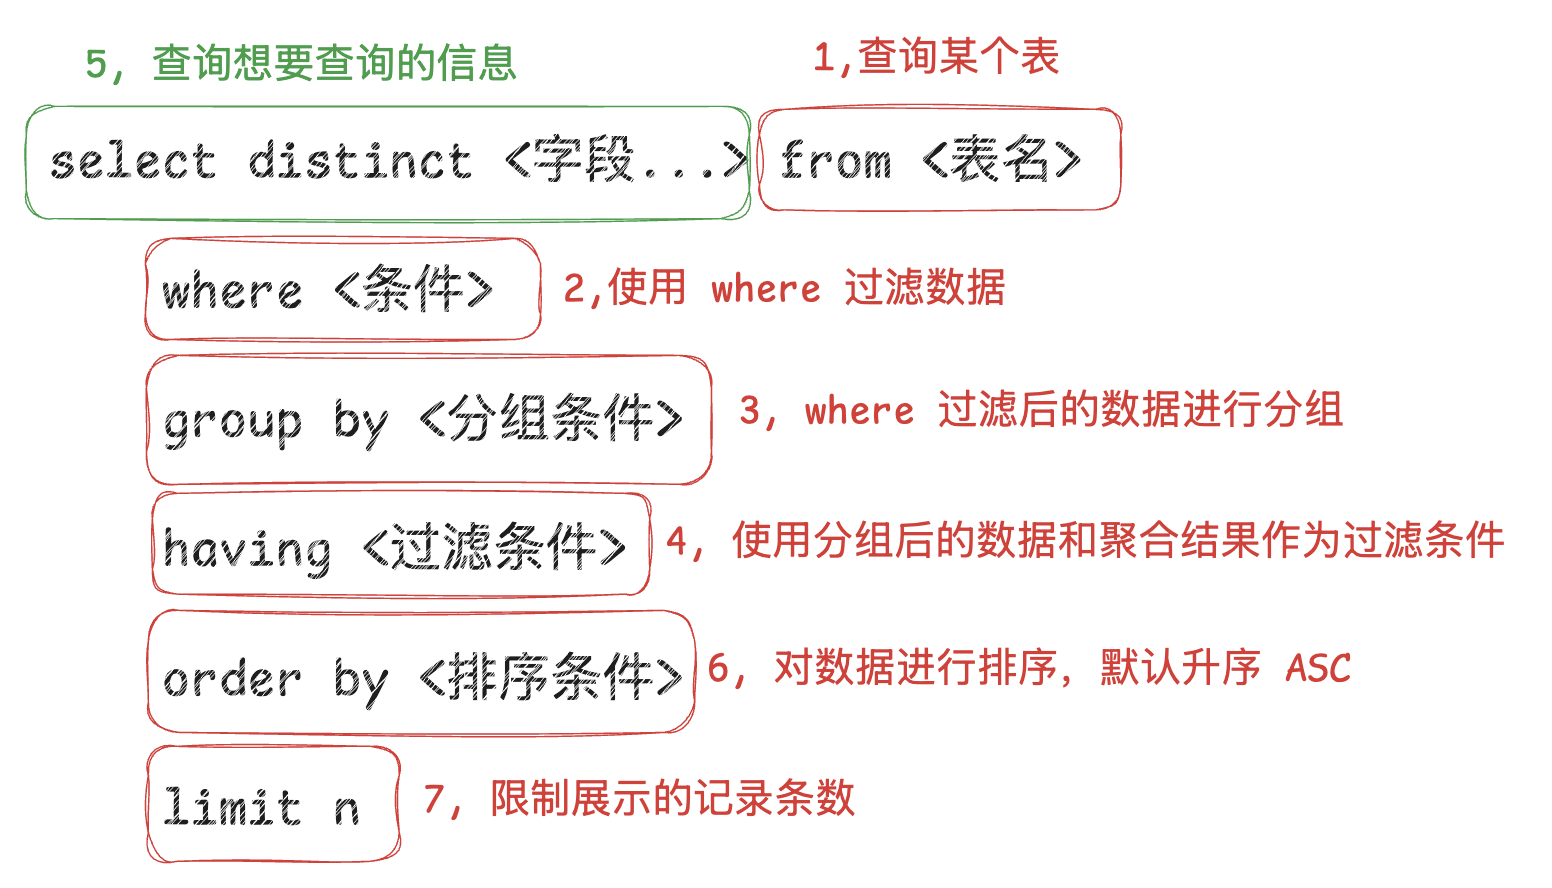
-- 书写顺序
select -> from -> where -> group by -> having -> order by -> limit

-- 执行顺序
from -> where -> group by -> having -> select -> order by -> limit
单表查询假数据;
-- 创建表;
create table t1 (
  id int primary key not null auto_increment,
  name varchar(16) not null,
  gender enum('male', 'female') not null,
  age int not null,
  salary float,
  dep varchar(32),
  notes varchar(64)
);
-- 通过 ai 生成测试数据,用于练习
-- AI Prompt: 基于上述表结构随机增加 100 条数据,用于练习单表的 CURD 语句;
四则运算
查询出来的数据是支持数学运算的;比如查询所有员工的年薪;
select name, salary * 12 from emp;

-- 通过上面查询来的虚拟表,表头为 `name` `salary * 12` 这样显示很不直观;
-- 可以通过 as 给年薪设置一个合理的表头
select name, salary * 12 as year_salary from emp;
格式化显示 concat
-- 可以将数据查询出 姓名: xx年龄: xx | 薪资:xx 的这种结果,算是对结果的 format
select concat('姓名: ', name, '年龄: ', age), concat('薪资:', salary) from emp;
where 过滤条件
where 后跟基本的运算表达式;
andor表示或和且的关系;between表示某个数据的区间;between 10 and 20,这是闭合区间;前后包含。in表示包含的关系;age in (10, 20, 30)not表示否的关系;直接not in | not between | not like和运算表达式一起not (age > 10 as age < 20)is null | is not null对空的判断;like模糊匹配_匹配一个字符%匹配多个字符
-- 查询大于 35 岁的 name 和 age
select name, age from emp where age > 35;

-- 多条件使用 and 进行拼接
select name, age from emp where dep = '技术部' and age > 35;

-- 也可以使用 between, 查询 age 20 到 40 之间的数据
select name, age from emp where age between 20 and 40; -- 闭区间:包含 20 和 40
-- 等价于
select name, age from emp where age >= 20 and age <= 40;

-- 此外逻辑关键字还有 not 和 or
select name, age from emp where age < 20 or age > 40;
-- 可以把 between x and y 当成一个固定公式,总是会一起出现
select name, age from emp where not age between 20 and 40;

-- 通过 in 判定符合一组条件的数据
select name, salary from emp where salary in (3000, 4000, 5000);

-- 通过 is null 或者 is not null 判断数据是否为 null
select * from emp where notes is null;
select * from emp where notes is not null;

-- like 模糊匹配
select name from emp where name like '荀_'; -- 所有荀开头的 2 个字符的 name 都会被查询
select name from emp where name like '丁_'; -- 所有丁开头的 name 都会被查询出来
group by 分组条件
查询的数据只能是分组后的数据,主要的目的是为了对分组后的数据进行处理(聚合函数)。
聚合函数包含 count | max | min | sum | avg;
但是如果不使用 group by 默认就是一个分组,也可以直接使用这些聚合函数。
-- 根据 dep 进行分组后就只能查询 dep
select dep from emp group by dep;

-- 统计每个部分的员工数量
select dep, count(id) from emp group by dep;
-- 统计每个部分中年龄最大的员工
select dep, max(age) from emp group by dep;
-- 统计每个部分中薪资最低一个
select dep, min(salary) from emp group by dep;
-- 统计每个部分中的平均年龄
select dep, avg(age) from emp group by dep;
-- 统计每个部分的工资总和
select dep, sum(salary) from emp group by dep;
group_concat 聚合函数,将分组内的数据使用指定的分隔符拼接,默认是英文逗号;
支持通过 distinct 去重和 separator 指定分隔符;
-- 查询每个部分的所有员工
-- as 列名 name
-- separator 使用 - 分割
-- distinct 对结果去重
select dep, group_concat(distinct name separator '-') as name from emp group by dep;

-- 查询每个部门年龄大于 45 的员工数量
select dep, count(id) from emp where age > 45 group by dep;

-- 统计男员工和女员工的数量
select gender, count(id) from emp group by gender;
having 过滤条件
作用和 where 一致,但是执行顺序在 group by 之后;
留给 having 的数据只有分组字段和聚合结果;所以 having 可以使用聚合结果作为条件
-- 查询所有部门内员工数量小于 5 的部门名,以及该部门内的员工名和员工数量
select dep, group_concat(name), count(id) from emp group by dep having count(id) < 5;

-- 查询各部门年龄大于 35 的员工超过 3 个人的部门名,以及大于 35 的人数
select dep, count(id) from emp where age > 35 group by dep having count(id) > 3;
order by 排序
ASC 升序 DESC 降序,默认 ASC
-- 对所有员工,按照工资进行升序;
select * from emp order by salary; -- 默认升序可以不用谢

-- 对所有员工,按照工资进行降序
select * from emp order by salary desc;
但是不免会碰到某一列数据多个数据相同的情况可以通过指定多个字段的排序,条件依次执行;
-- 按照工资降序、工资相同按照 id 降序
select * from emp order by salary desc, id desc;
limit 限制展示数量
select * from emp limit 5;

-- 工资最高的 5 个人
select * from emp order by salary desc limit 5;

-- 分页
-- 第 1 条数据开始,取 10 条数据
select * from emp limit 0,10;
select * from emp limit 10, 10; -- 第 11 条开始,取 10 条数据